WeChat 公開記事を Markdown 化

公式アカウント記事向け WeChat スクレイパー API

WeChat の公開記事 URL を Crawl エンドポイントに送るだけ。記事本文、アカウント名、公開時刻、画像 URL がクリーンな Markdown で返ります。WeChat アカウントは不要です。

エンドポイントbash
POST https://api.search1api.com/crawl
{ "url": "https://mp.weixin.qq.com/s/jUylk813LYbKw0sLiIttTQ" }
対応しているページ

専用パーサーが記事本文を抽出 — WeChat が公開記事ページに配信するコンテンツそのもの。

1
記事本文

記事全文をクリーンな Markdown で — #js_content から見出し・リスト・書式を保持。

2
アカウントと時刻

公式アカウント名と公開タイムスタンプが構造化メタデータに。

3
画像 URL

記事内の全画像が metadata.imageUrls に — インラインの base64 ブロブはなし。

用途

中国語コンテンツの RAG / アカウント監視 / アーカイブパイプライン

入力と出力

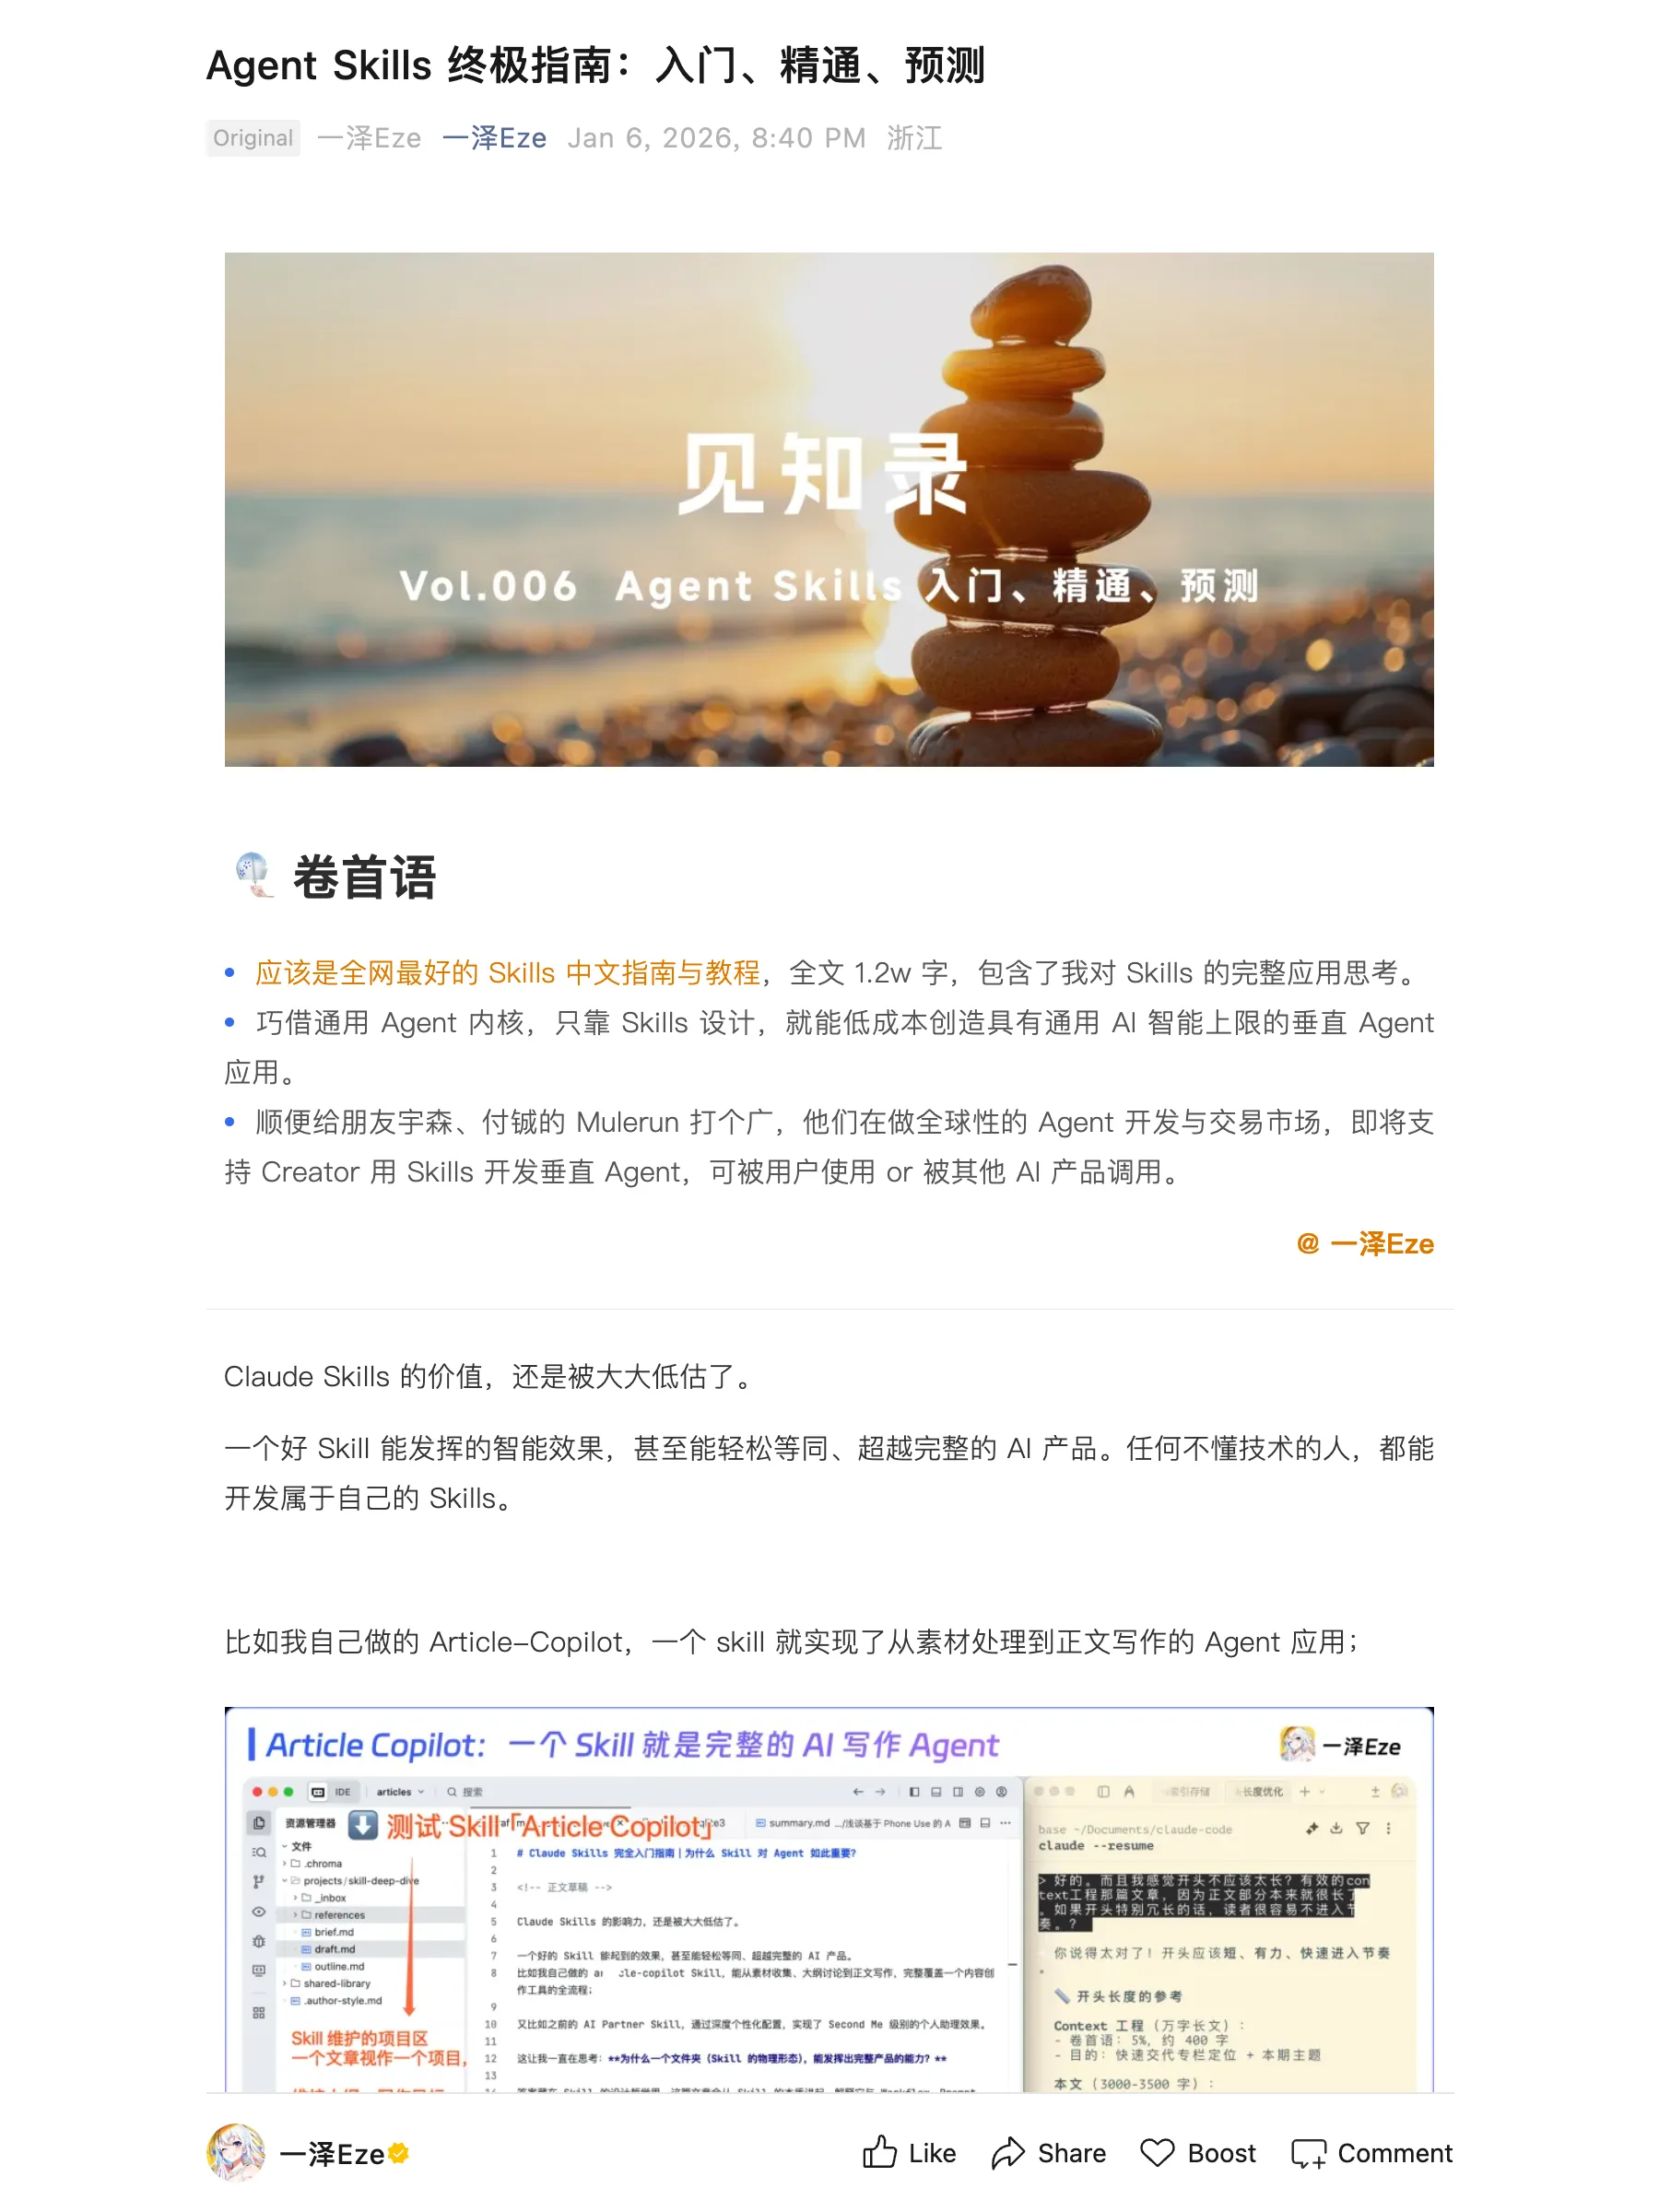
実際の公開記事 1 本。左は WeChat が匿名読者に実際に配信するページのスクリーンショット(クローラーと同じ経路で撮影)、右は API が返す results.content の全文です。

記事mp.weixin.qq.com/s/jUylk813LYbKw0sLiIttTQ

WeChat が返すもの

匿名読者に配信される Agent Skills についての WeChat 公式アカウント記事

5.1 MB の描画 HTML — 広告モジュール、QR カード、関連記事込み

API が返すもの

markdown
# Agent Skills 终极指南:入门、精通、预测
🎐 卷首语应该是全网最好的 Skills 中文指南与教程,全文 1.2w 字,包含了我对 Skills 的完整应用思考。巧借通用 Agent 内核,只靠 Skills 设计,就能低成本创造具有通用 AI 智能上限的垂直 Agent 应用。顺便给朋友宇森、付铖的 Mulerun 打个广,他们在做全球性的 Agent 开发与交易市场,即将支持 Creator 用 Skills 开发垂直 Agent,可被用户使用 or 被其他 AI 产品调用。@ 一泽EzeClaude Skills 的价值,还是被大大低估了。一个好 Skill 能发挥的智能效果,甚至能轻松等同、超越完整的 AI 产品。任何不懂技术的人,都能开发属于自己的 Skills。比如我自己做的 Article-Copilot,一个 skill 就实现了从素材处理到正文写作的 Agent 应用;又如 AI Partner Skill,让通用 Agent 深度学习你的记忆,塑造懂你的 AI 伴侣,给到个性回应。在研读 Anthropic 官方技术博客,与持续 Agent Skill 实验之后,形成了这份全网最完整的 Skill 指南,包含:1.最容易读懂的 Skills 概念与原理介绍2.讨论 Skills 的真实价值、技术优势、对 AI 产品设计的影响3.非常完整的 Skills 使用与开发教程4.Skills 的场景识别,什么时候适合开发、使用 Skills?从概念澄清、运作机制,到实践教程、应用价值,与你在本期分享。👉文末会拉一个 Skill 中文社群,专项讨论与实践 Agent Skills,加入方式见底部。一、Skills 是什么:从概念来源到运作原理2025 年 10 月中旬,Anthropic 正式发布 Claude Skills。两个月后,Agent Skills 作为开放标准被进一步发布,意在引导一个新的 AI Agent 开发生态。OpenAI、Github、VS Code、Cursor 均已跟进。为了更好的理解,你可以把 Skills 理解为“通用 Agent 的扩展包”:Agent 可通过加载不同的 Skills 包,来具备不同的专业知识、工具使用能力,稳定完成特定任务。最常见的疑惑是:这和 MCP 有什么区别?MCP 是一种开放标准的协议,关注的是 AI 如何以统一方式调用外部的工具、数据和服务,本身不定义任务逻辑或执行流程。Skill 则教 Agent 如何完整处理特定工作,它将执行方法、工具调用方式以及相关知识材料,封装为一个完整的「能力扩展包」,使 Agent 具备稳定、可复用的做事方法。以 Anthropic 官方 Skills 为例:PDF:包含  PDF 合并、拆分、文本提取等代码脚本,教会 Agent 如何处理 PDF 文件 - 提取文本,创建新的 PDF、合并或拆分文档。Brand-guidelines:包含品牌设计规范、Logo 资源等,Agent 设计网站、海报时,可参考 Skill 内的设计资源,自动遵循企业设计规范。Skill-Creator:把创建 Skill 的方法打包成元 Skill,让 AI 发起 Skill 创建流程,引导用户创建出符合需求的高水准 Skill。Skill-Creator:教 Agent 如何帮用户创建新 Agent 的技能但 Skills 的价值上限,远不止于此。它应该是一种极其泛用的新范式,从垂直 Agent 到 AI 产品开发:借用通用 Agent 内核,0 难度创造具备通用 AI 智能的垂直 Agent 应用。本文开头提到的 article-copilot、AI Partner Skill,就是对这种可能性的验证。让我们从 Skill 的运作原理讲起。首先,如何理解 Skill? Anthropic 说:Skills  是模块化的能力,扩展了 Agent 的功能。每个Skill 都打包了 LLM 指令、元数据、可选资源(脚本、模板等),Agent 会在需要时自动使用他们。我有个更直观的解释:Skill 就像给 Agent 准备的工作交接 SOP 大礼包:想象你要把一项工作交给新同事。若不准口口相传,只靠文档交接(而且你想一次性交接完成,以后不被打扰),你会准备什么?任务的执行 SOP 与必要背景知识(这件事大致怎么做)工具的使用说明(用什么软件、怎么操作)要用到的模板、素材(历史案例、格式规范)可能遇到的问题、规范、解决方案(细节指引补充)⬇️Skill 的设计架构,几乎是交接大礼包的数字版本:相对标准的 Skill 结构示例,实际案例中,只有 SKILL.md 是必需的,其他结构为可选项在 Skill 中,指令文档用于灵活指导,代码用于可靠性调用,资源用于事实查找与参考。当 Agent 运行某个 Skill 时,就会:1.以 SKILL.md 为第一指引2.结合任务情况,判断何时需要调用代码脚本(scripts)、翻阅参考文档(ref.)、使用素材资源(assets)3.通过“规划-执行-观察”的交错式反馈循环,完成任务目标当然,Skill 也可以用来扩展 Agent 的工具、MCP 使用边界,通过文档与脚本,也可以教会 Agent 连接并使用特定的外部工具、MCP 服务。举个例子,这是 PPTX Skill 的文件目录:整个文件夹就是一个完整的能力包,用来支持 AI 创建、编辑和分析 PowerPoint 演示文稿。核心文件是 SKILL.md,包含技能的元数据和任务指导,告诉 agent 什么时候使用这个技能、如何按步骤处理任务。特别的,独立子技能往往会被拆为子文档(如教 AI 把 html 导出为 pptx 流程的 html2pptx.md),以避免一次性加载过长的 skill 文档,节省上下文窗口Scripts/ 包含 Agent 可用的各类预先写好的程序脚本,比如 html 转 pptx 的一键程序脚本。这样 Agent 运行任务时就无需临时开发工具,直接调用,节省 tokens ,避免出错,提升速度也有一些参考文档(此项目打包的不算规范,但根据 SKILL.md ,Agent 也能理解哪些文档可以参考),比如 ooxml.md,是对 ooxml 格式文件的解析指南整个 Skill 以简明的形式,把技能指引文档、代码脚本、参考文档和可用资源组合,定向扩展了 Agent 完成 pptx 生成相关的工作能力。Skills 的真实价值:垂直 Agent 的未来态看好 Skills 价值与未来生态发展的原因是,Skills 与其他 AI 应用开发方式,有底层机制的不同:人给出专业知识与工具方法,通用 Agent 提供智能,自主理解,主动执行。说人话就是:人给指引,最终 Agent 还能根据自己的智力看着执行。而且「Agent + 文件」的形式,足够泛用。这就相较于它的前辈们(Workflow 和程序编写的 AI 应用)有了 3 个关键优势:非技术人员可用零代码、自然语言编写能突破预设限制,灵活响应用户输入,应对边缘情况甚至能多个 Skill 自由联用,应用方式极其灵活这一部分可能会比较深入,但例证完善,实际上不会很难懂。虽一家之言,但仍有助于理解 Skill 价值与 Agent 发展趋势1. 零代码、自然语言,编写真·智能 Agent纵观此前的 AI 应用开发方法:不必多说程序编写的 AI 应用,必须懂程序逻辑、懂技术实现。即便是 Coze、Dify、N8N 等近年流行的 Workflow 平台,也得理解节点配置、条件分支,仍算「编程」,只是界面友好一些。而 Skills 的创建门槛,完全不同:入门门槛极低,智能上限极高。1)最简单的,以 Anthropic 的 brand-guidelines skill 为例仅有一个 SKILL.md,纯自然语言写成。元信息:什么时候用这个 Skill正文:品牌颜色、字体等文本描述信息但足以引导 Agent 变成符合 Anthropic 品牌设计的垂直 Agent,可用于品牌官网、海报、PPT 设计。当你要设计一个符合 Anthropic 公司设计规范的 AI 搜索网站,Agent 就会自动运行该 Skill ⬇️Skill 有两种加载模式:显式 / 隐式。前者通过 user query 直接指定调用;后者根据任务与元信息描述的相关性,LLM 自动匹配。这是该 skill agent 一次性开发的网站,调性接近 Claude 官网设计:(我电脑上缺了他家的 Serif 字体,实际上可以更像)2)复杂的,以 AI-Partner Skill 为例,一个 Skill 就是一个复杂 Agent包含 SKILL 文档、向量数据库构建指南、向量数据库使用脚本、AI 伴侣与用户的 Persona 模板资源SKILL.md 本体依然由自然语言写成:借此,Agent 就能理解 AI-Partner 的初始化与对话方法,引导用户上传包含个人记忆的文档预料,在用户端智能切分笔记片段,构建向量数据:解析用户记忆文档,提炼个性化的 AI 伴侣与用户画像设定:最终智能检索用户记忆,提供懂用户的 AI Partner 对话体验:这能基本验证:单靠 Skill + Agent 所构造的垂直 Agent,所实现的智能效果,无异甚至可超过同类 AI 产品。而做这些垂直 Agent,都不用编写程序代码。非技术出身的领域专家,离自己做专业 Agent 只剩隔着一层窗户纸——把你的专业经验和工作流程,用文档形式写清楚,Agent 就能照着执行。2. 突破预设限制,灵活应对实际情况Agents Skill 的这一优势往往被忽视。Workflow 或 传统程序 的核心问题是,它们假设所有情况都能预设。比如基于用户记忆的 AI 个性化助理,往往需要提前设定:用户导入记忆文件的入口允许用户上传的文件格式数据应该包含哪些字段以及可能出现哪些特殊情况,每种情况如何处理。但现实往往是:需要教育用户在哪点击「导入」用户只有预期之外的格式:预期支持 md,但实际只有 doc数据字段不符:预期每个文件需要一个标题,但用户文件没有标题或者出现了预设之外的边缘情况。这时 Workflow 或传统程序就卡住了,它只能按预设路径执行,遇到意外就报错,或要求用户自行消除差距。而通用 Agent + Skill 应用的运作方式完全不同:能在统一的对话框,接收各类用户数据(文本、文件、图片)能自主调用其他 Skill,或即时编写 doc2md 脚本,自动转换用户格式能提炼补充每个文件的标题,完成数据入库处理能基于 LLM 的推理智能,弥合各类边缘问题用 Skill 做的垂直 Agent,以 Skill 的知识与方法为指引,能巧借 Agent 内的 LLM 智能,灵活应对各类问题。所以在 AI-Partner-Chat 中,也有过很有意思的探索:借 Agent 本身的“观察-规划-执行”的动态智能,对用户文档进行自适应切片,而非所有文件都按照固定的分隔符 or 字数切分。(DailyNotes 按照日期标题切分;项目笔记按照标题级别与语义切分)这样能得到更符合实际情况的 RAG 切片。3. 多 Skills 自由联用Agent Skills 实质仍是 Context 工程,Skills 只是把垂直领域的知识、脚本调用方法等挂载到 Agent 的上下文窗口。所以 Skills 在实际应用中极其灵活,甚至在一次任务中能调用多个 Skill。比如:联用 brand-guidelines + pptx,自动制作符合品牌规范的 pptx联用 AI-Partner-Chat + Article-Copilot,写出更符合个人思考与文风的内容也可以是更复杂的场景,如做一份产品分析报告:1.从网页抓取竞品数据(Web Scraping Skill)2.提取 PDF 中的用户反馈(PDF Skill)3.分析数据并生成图表(Data Analysis Skill)4.按品牌规范制作 PPT(Brand Guidelines + PPTX Skill)每多一个 Skill,就多一种能力,N 个 Skill 可以应对远超 N 的应用场景。☞ Skills 核心运行机制:渐进式披露👉这节旨在讲解 Skills 运作的核心机制之一:渐进式披露。整体更偏技术理解,如果只是想用 or 做 Skill,可以滑到下一部分正如 有效的 Context 工程 所论证的,上下文过长容易导致模型能力下降。由于 Skills 的本质就是 Context 工程,所以这个问题也需在 Skill Agent 中注意。一个完整装载了 Skill 的 Agent 架构是这样的:Skill 包放在 Agent 文件系统(右侧)中,并非默认全量加载在 Context Window 中。根据 Context 加载顺序、优先级的不同,Skill 被划分为了 3 种层级:Skill 内容物的 3 种渐进披露优先级渐进披露的流程图解1)Level 1(元数据,始终加载):SKILL.md 文档内的元数据,包含名称与用途描述。长度约 100 tokens。Agent 启动时,就在 Context Window 中加载 Skill 元数据,将其包含在系统提示中。AI 通过理解用户消息与 Skills 元数据的匹配情况,判断是否需要自动使用技能。---name: pdfdescription: 全面的 PDF 操作工具包,用于提取文本和表格、创建新 PDF、合并/拆分文档以及处理表单。当 Claude 需要填写 PDF 表单或大规模地程序化处理、生成或分析 PDF 文档时使用。---默认只加载元数据 → 意味着可以给一个 Agent 同时安装很多 Skills 但不影响上下文性能。2)Level 2(指令,触发时加载):SKILL.md 文档内的正文内容,也就是主要技能指令,一般包含工作流程、最佳实践和指导。建议少于 5000 tokens。当用户发出的消息与Skill 元数据的描述匹配,需要调用 Skill 时,Agent 才会用 bash 读取文档正文 。读取时文档内容加载到 Context Window 中。SKILL.md 的结构:分为 YAML 元数据与 MD 正文3)Level 3(子技能指令 / 资源 / 代码,按需动态加载):由子技能文档、代码脚本、参考文档、可用资源等文件构成。也有 Agent Skill 规范文档将它们统称为「Resource」。相对来讲,Level 3 结构要求没那么严谨。Sub-SKILL.md 子技能文档:相对独立、复杂的子技能指令,单独放在 Level3 拆分加载随着一个 Skill 的复杂度提升,可能因为技能知识的上下文过长,或者有些知识仅在特定场景使用,而不适合放入单个SKILL.md,可被分拆为独立指令文档,仅在必要时加载。Scripts 代码脚本:视作“Agent 的可执行资源”,而不算 tool use(tool use 是 Agent 外部调用的独立服务)Agent 在 Agent 电脑(虚拟机)中直接调用脚本,脚本代码本身不进 Context Window,只有脚本运行完成后的输出会进 Agent 的 Context。Reference 参考文档、Assets 可用资源,当然都是 Level 3,仅在必需时动态读取加载。Level 3 因为按需加载的特性,文件在被访问前不会占用 Context 长度,所以没有内容大小限制,可按业务实际说明需要添加材料。⬇️小结:整个 Skill 运行过程中,Agent 自动判断哪些技能与任务相关,根据 skills 的元信息,动态判断、加载完成任务所需模块:Level 1: SKILL.md 元数据(name + description)         ↓Level 2: SKILL.md 完整内容         ↓Level 3: Resources 中的具体文件(按需读取)公众号 @言午 在《Claude Skills背后的信息分层设计哲学》一文中,亦有形象的图解:👉不过,即使 Agent Skill 支持「渐进式披露」。但在商业化的 Agent 产品中,单个或多个 Skills 联用,如何稳定控制运行过程中的 Context 长度,依然是绕不过的工程问题。☞ Skills 对 AI 产品设计的影响我先和在做 Agent 平台的朋友 @付铖 讨论了一个问题:基于 Skills 做的垂直 Agent 应用,会不会有依赖推理,响应速度降低的问题?我俩是在 Mulerun Agent 开发者闭门会认识的,当时觉得他的 Agent 认知相当深刻。他负责的正是 Mulerun 平台的产品策划与研发。他给了一组很有意思的启发:1.Skills 是一种非常宽容的 Agent 设计架构2.Skills 可以被设计为很多 tokens 的指令文档,引导模型思考;也可以是无需思考的简单指令,直接指向可直接运行的脚本代码3.因为 Skills 能直接调用代码逻辑,不进 Context 窗口。所以用 skill 也不需要 agent 一直推理,agent 也可以只承担类似 hook 的角色,实质上和正常程序运行并无差别4.所以 Skills 慢起来可以是 prompt,快起来也可以是 workflow另外,再结合两个趋势的极端判断:1.token 价格会下降2.agent 速度会提升这么看来,以 Skills 为基础的垂直 Agent,在性能、开销上的问题,也不是不可解决的持续性问题了。所以,进一步推演未来 ai native 产品的发展趋势,我目前的猜测是:拿笔记类 APP 举例,大部分 APP 的逻辑还是:新笔记 -> 代码 -> 处理。新笔记完全用代码逻辑,原模原样直接入库。但如果是 ai native 式的笔记 APP,他们可能会内置一些类似 skill 的指引,包括笔记入库、智能纠错、冗余笔记合并等。这些 skill 有些可能以 prompt 为主(需要生成),有些基本只有代码逻辑(快速响应)。当用户写新笔记时,ai 快速自行判断:能不能直接入库?要不要智能纠错?有没有冗余的历史相似笔记需要合并?每种情况,都由 agent 拿着各种 skills 自动匹配来处理。这样下来,Skills-based 的 Agent 产品,就能用同一个多模态输入框,处理用户各种不同的输入,也能灵活应对未被规划的边缘问题、为用户提供绝对个性化的生成需求了。二、Skills 完全教程:制作与使用如果你看到了这里,那 Skills 对于 AI 应用开发的价值就不言而喻了:👉巧借通用 Agent 内核,只关注 Skills 设计,能低成本创造兼具通用 AI 智能上限的垂直 Agent 应用。对于 Agent 开发者,尤其是非技术出身的团队 or 业务人员,是极大的开发利好:1.0 代码创造 Agent 应用,仅靠“写文档”的方式,人人能做出可解决问题的垂直 Agent2.无需过度关注 Agent 工程技术细节,凭借通用 Agent 智能,Skill Agent 能够自适应 Skill 设计中所缺失的代码、功能逻辑,甚至是自行在运行中克服 bug(虽有性能影响)。做 Demo、MVP、甚至小 Agent 应用,验证产品价值就非常容易3.而且搓出来的垂直 Agent,兼具通用 AI 智能,有极其灵活的边界问题与个性化处理能力,智能上限极高。那么,我们该如何开始使用 or 制作第一个 Skill?1️⃣ 教程:我该如何使用 Skills?(Claude Code 版)👉如果你已经会了,可跳过此部分;也可以把这大概率是全网最详细的 Skills 教程,转给初学的小伙伴们使用 Skills 的方式很多,我先推荐一种自己用最多的本地方法,Claude Code(简称 CC)。注意:只是使用工具,Claude 模型并非必需BTW:codex、cursor 等工具也逐步在支持 skill 的使用,有兴趣可以自行探索。开个玩笑:Claude Code 是 Anthropic 推出的 coding 工具 ❌Claude Code 是 Anthropic 自己都没想到的通用 Agent 框架 ✅CC 能做的事情远不止 AI Coding:它能代替我们操作电脑,包括搜索网页、操作浏览器、访问文件,以及使用电脑底层命令、运行 python 脚本等行为。这就意味着 CC + Skills,就等于跑在自己电脑上的垂直 Agent。通过安装或自行创建不同的 Skills,就可以完成:搜索网络信息,总结感兴趣的资讯日报;自动化翻阅项目文件夹,输出项目复盘文档;以及其他不同的 Agent 任务。使用方法其实并不复杂,只是需要一些耐心:Step 1:安装 Claude Code如果从未安装过 Claude Code,请打开「终端/命令行」工具:遵循官方安装指引 https://code.claude.com/docs/en/quickstart#native-install-recommended ,完成 Claude Code 安装。推荐直接把官方指引链接,按以下 Prompt 发给任意 AI(ChatGPT、Kimi 都行),让它一步步教你。我是电脑小白,参考以下信息,一步步指导我在【Mac/windows/linux】终端中安装该程序:【此处粘贴替换为官方安装指引文本】当我遇到疑惑或报错时,我会把终端的日志发给你,请帮我解决。AI 就会这样教你安装:遇到问题就截图给它,基本都能教你解决。安装后,终端里输入claude --version,看到版本号,则这一步安装成功。Step 2:如果不用 Claude 模型,请替换模型现在大部分国产模型都已经支持了 Skill 的使用与创建。❶ 你可以用「模型名称 + Claude Code」的关键词去网上搜索模型厂商官方的 Claude Code 模型接入教程。目前比较推荐的是 GLM 4.7、Kimi K2-thinking 或新版本。发送以下 Prompt 给 AI 对话,就能得到详细的人话指导了:我是电脑小白,指导我根据【替换为教程链接】,并替换 claude code 内的模型。Claude Code 已经装好了❷ 另外,也有一些好用的 Claude Code 模型管理工具,比如「CC Swtich」,项目地址为 https://github.com/farion1231/cc-switch同样打开 AI,发送以下 Prompt,就能学会如何使用:我是电脑小白,指导我如何安装【项目地址】,并替换 claude code 内的模型,我要用的是【模型名称】Step 3:安装并使用 Skills正式使用 Claude Code 之前,建议在任意目录下创建一个空文件夹,比如叫 test,再在终端内切换到对应文件目录:然后在终端输入claude,就可以启动 CC 了,看到下图就是启动成功了这一步能把 Claude Code 的后续 AI 行为,都局限在该目录,减小对本地电脑其他文件的影响。❶ 在安装 Skill 之前,你需要先获取需要的 Skill 文件包。比如官方 Skills 仓库:https://github.com/anthropics/skills/tree/main,里面就有很多已经做好的 Skills。你可以让 CC 替你自动安装 Skill,比如在 CC 中发送 安装 skill,skill 项目地址为:<skill 项目地址>❷ 也可以手动下载 Skill,把文件包解压后,放在 skills 安装目录下:可以在当前项目文件夹的/.claude/skills/目录下,放入要安装的 skill 文件包:(如图为正确的项目 skills 路径配置)也可以选择全局目录~/.claude/skills/(所有项目都能共享放在全局目录的 Skill)❸ 完成安装后,记得重启 CC  👉 退出终端再打开就行,或者双击 ctrl+c 终止 CC 进程)⬇️要使用 Skill 时,只要在装好后的 CC 中,发送开始使用<skill 名称>,或者用户消息与 skill 元数据的描述匹配,就能自动调用 Skills,执行任务。👉之前实验 AI-Partner Skills 分享过的 step by step 教程,能进一步体验复杂 Skill 的智能上限。非常细致,值得参考:只用 Claude Skills,打造专属 AI 伴侣|附完整教程👉 怎么找到好用的 Skills 呢?你应该也看出来了,在面向 to C 用户(也就是自己日常使用)时,以上的方法有两个问题:使用步骤确实比日常的 APP 复杂不少比较难找到想用的 Skills常规方法是找规模比较大的第三方 Skills 市场:https://skillsmp.com/zh但不难发现,现有大部分的 Skills 公开市场,没有完善的评价和精选体系,所有 Skill 缺少合理的分类与排序机制,导致很难找到需要的 Skills。可以看到仅靠 star 排序,是非常难找到合适的精选 Skill 的付铖他们的 Mulerun 最近就在研究解决这个问题,顺手给他们恰逢其时地推荐一下:他们在打造全球性的 Agent 市场,支持创作者在平台上开发并上架 Skill、N8N 等形式的 AI Agent他们会帮助 Agent 创作者做全球分发、增长(类似 Agent 向的 APP Store),且上架 Mulerun 后,Agent 能被其他用户付费使用Mulerun 也即将支持 Agent Skills 生态,还会有个好功能:一键运行并测试 github上公开的 skill repo(也就是省掉了 CC 那样配置 Skill 的步骤)另外,还会引入自动评分、精选的 Skills 发现机制,帮助用户能够更好地找到自己需要的优质 Skills2️⃣ 如何制作一个 Skill?好,话说回来。如果你按照上文,学会了 Skill 安装与使用,那制作第一个 Skill 将会无比容易。我们需要用到 Anthropic 官方的一个 skill:skill-creator顾名思义,用来帮你自动开发 Skill 的 Skill(我的 AI-Partner 和 Article-Copilot Skills 也都借助了这个 skill,大幅提升开发 skill 的效率)❶ 首先是安装 skill-creator,skill 项目地址在:https://github.com/anthropics/skills/tree/main/skills/skill-creator,安装过程一如上面的教程,请 CC 来帮忙自动安装:❷ 安装完成后,即可调用 skill-creator 自动创建需要的 skill。比如,发送创建需求给 CC:CC 自动调用 skill-creator,编写 SKILL.md 与 pdf2word 脚本最终提示创建成功:你也可以试着:“创建 skill,能按照我写文章的行文风格写文章”“创建 skill,能自动整理近期 XX 领域的新闻日报”……👉 如何安装自己做好 skill ?这种方式做出来的 skill,会默认是xx.skill格式,会与 zip 或文件夹格式略有区别。是 skill-creator 创建的 skill 压缩格式。告诉 CC 指定 .skill 的文件地址,要求 cc 直接安装 skill 即可:如果是文件夹或者 zip,那就按上文的介绍,手动解压放到对应 skills 目录即可。👉 【进阶】如果你需要精调 skill,或者想完全手写一个 skill?更细节的 Skill 规格设计说明,请参考:https://agentskills.io/specification#skill-md-formatBTW:Mulerun 本月也会开始内测 Agent Builder 功能,会着重用到 skill,对 skill 开发方法进一步优化。如果你想讨论 skill,可以去他们的社区:https://community.mulerun.com/t/topic/73 ,已经积累了一些开发者讨论(付铖回头记得请我吃饭啊喂)三、什么时候应该用 Skills?概念、价值、教程,都讲完了,但更重要的问题是:什么场景值得“用 Skill 来解决”、“开发一个 Skill”?这个问题对于普通用户优化 AI 工作流程,开发者找 Skills Agent 创业机会,同样重要。根据 Anthropic 官方博客建议,与我的实际理解,梳理了 3 种明显的时机:1️⃣ 发现自己在向 AI 反复解释同一件事最典型的信号是:为了完成某个任务,在多轮对话中,需要不断向 AI 解释一件事应该怎么做。比如:“帮我写一份技术文档”“不对,我们公司的技术文档格式是这样的……”“还有,代码示例要按这个模板来……”“上次不是说了吗,章节标题要三级标题……”“帮我分析这个数据”“先把 > XX 的异常值筛掉”“不对,应该用中位数,不是平均值”“图表要按我们公司文档的配色方案……”这时候就该想到:与其每次都解释一遍,不如把这些规则打包成一个 Skill,一次创建永久复用。2️⃣ 某些任务需要特定知识、模板、材料才能做好有时候是 AI 的通用能力够了,但缺“特定场景的知识材料”。典型场景:技术文档写作:需要参考代码规范、术语表,使用文档模板品牌设计:需要参考品牌手册、色彩规范,使用 Logo 资源数据分析:需要参考指标定义、计算公式,使用报表模板……这些都是「通用 Agent + 垂直知识」的典型场景:人提供材料,Agent 才能具备场景 Context。在 Skill 包里放对应的知识材料,比如把模板、规范、案例放到 Skill 的assets/、reference/目录,或者直接描述在SKILL.md中,Agent 就能一次性输出符合任务需要的精准结果。3️⃣ 发现一个任务要多个流程协同完成有些任务更加复杂,往往需要“组合多个流程”才能完成。竞品分析报告:检索竞品数据 + 数据分析 + 制作 PPT内容生产:收集参考资料 + 学习风格 + 大纲协作 + 正文写作我相信你的工作环境里也有很多这种任务。把这类任务中每个环节的指令文档、可执行脚本、参考材料、可用资源打包成单个或多个 Skill 也是不错的 AI 解决方法。让Agent 根据任务描述,智能调用不同的 Skill 模块,通过“规划-执行-观察”的交错式行动,一次性完成原本需要多个流程协同完成的复杂任务。🎐 写在最后写到这里,回到开头那个判断:Claude Skills 的价值,还是被大大低估了。Skills 是 Agent 的灵魂,就像 Steam 游戏 + 创意工坊一样。有了这种可扩展性极强的设计架构,Agent 开发者完全能巧借通用 Agent 内核,只需关注 Skills 本身的设计,就能低成本创造兼具通用 AI 智能上限的垂直 Agent 应用。对于Agent 创业者,乃至非技术的领域专家来说,Skills 无异代表了很多的新机会:垂直 Agent 工具,如果按传统方式开发,周期至少数周。但用 Skill 的方式,几小时甚至几分钟就能测试起来,且智力与能力上限也有机会直逼通用 Agent。⬇️这不是说 Agent Skill 必然全面替代传统开发。两种方式各有适用场景,但 Skill 确实让更多人、更多场景接入 Agent 能力变得更为可行:不必为了一个内部小工具开发完整产品,打包个 Skill 就能解决不必说服 IT 团队理解你的需求,自己就能创建工具不必等待产品迭代,你可以随时调整 Skill 的行为从这个角度看,Skill 更是降低了验证想法的成本。另外再换一个思路:把 Skill Agent 服务打包为 AI API,是不是也能快速给已有的产品赋上好用的 AI 能力?现在还是 Skill 生态的早期,Agent Skills 开放标准发布不到 1 个月,工具在完善,社区在成长。但这个方向有意思的地方在于,终于能让更多人、组织、行业参与 AI 应用的创造了。👉 关于 skill 社群:关注本公众号⬇️,在聊天窗发送消息「skill」进群,与其他创作者交流经验,共同探索这个新兴生态的可能性。希望本文能对你有所启发,记得关注~也感谢你的点赞与分享:)Ref.Claude Doc - Agent Skills 说明:https://platform.claude.com/docs/en/agents-and-tools/agent-skills/overviewAgent Skills 开放标准:https://agentskills.io/homeEquipping agents for the real world with Agent Skills:https://www.anthropic.com/engineering/equipping-agents-for-the-real-world-with-agent-skills
---
## Metadata
- Platform: weixin
- Account: 一泽Eze
- PublishedTime: 2026-01-07T01:40:00.000Z
- SourceURL: https://mp.weixin.qq.com/s/jUylk813LYbKw0sLiIttTQ
- Availability: full
- ImageCount: 52

記事全文 — 14 KB · アカウント + 公開時刻 + 12 件の画像 URL

URL パターン別の対応状況

WeChat 対応はドメイン単位ではなく URL パターン単位で計測しています。表の各行は本番クローラーで検証済みです。

URL パターンステータス取得できる内容
mp.weixin.qq.com/s/<id>
対応(出口依存)
公開記事は本文・アカウント・公開時刻・画像 URL を返します — ただし Tencent が一部の出口 IP にキャプチャを出すことがあります(下記参照)。
キャプチャに当たったリクエスト
具名エラー
Tencent がアンチボットページを返した場合、キャプチャのマークアップではなく ANTI_BOT 分類のエラーで失敗 — リトライで出口が切り替わります。

ラッパーを除いた公式アカウント記事

WeChat の記事ページは重く — 欲しい記事が数 MB のアカウント chrome、広告モジュール、関連記事 widget に埋もれています。Crawl エンドポイントに mp.weixin.qq.com の URL を渡すと、専用パーサーが記事本文にアカウント名・公開時刻・画像 URL を添えて抽出します。

ラッパーではなく本文

パーサーは記事コンテナを直接対象化 — アカウントカード、広告枠、共有 chrome がパイプラインに届くことはありません。

画像は URL で

記事の画像は metadata.imageUrls にリスト — 参照可能なリンクで、インラインブロブではありません。

アンチボットは隠さず命名

Tencent がデータセンター出口にキャプチャページを出すことがあり — そのリクエストはチャレンジマークアップを返さず、捕捉・リトライ可能な ANTI_BOT 分類のエラーで失敗します。

URL パターンごとに実測

表の各行は実際の URL をライブでクロールして再現したもの — ドメイン単位の主張ではなく、パターン単位の実測です。

WeChat スクレイパー API とは?

WeChat スクレイパー API は、mp.weixin.qq.com の記事 URL を受け取り記事を構造化されたモデル向け形式で返す HTTP インターフェースです。公式アカウント記事はウェブ上最大級の中国語テキスト群ですが、ページは 1 つのコンテンツコンテナを囲む密なラッパーです。Search1API の Crawl エンドポイントはそのコンテナを抽出する専用パーサーを使い — 本文、アカウント、公開時刻、画像リストを返し、Tencent のアンチボットが記事の代わりに応答した場合は正直に報告します。

実装の流れ

典型的なワークフロー

WeChat の公開記事 URL を Crawl エンドポイントに送るだけ。記事本文、アカウント名、公開時刻、画像 URL がクリーンな Markdown で返ります。WeChat アカウントは不要です。

1

mp.weixin.qq.com の記事 URL を Crawl エンドポイントに POST — WeChat アカウントは不要。

2

URL がパターンルールに照合され、専用 WeChat パーサーにルーティングされます。

3

記事が Markdown と results.metadata で返却 — アカウント、公開時刻、imageUrls。

4

Tencent がリクエストをチャレンジした場合、エラーに ANTI_BOT 分類が付きます — キャプチャページを取り込むのでなく捕捉してリトライ。

利用シーン

中国語記事を RAG パイプラインへ — 本文はクリーンに、画像は URL リストで到着。

公式アカウントの監視 — アカウント名と公開タイムスタンプがフィールドで返ります。

記事ごとにページラッパーを解析せず、公式アカウントの記事をアーカイブ。

リーディングリスト構築 — 記事 URL は本文を返し、周囲のメガバイトの chrome は返しません。

FAQ

WeChat アカウントは必要ですか?

不要です — 公開公式アカウント記事は匿名ブラウザに配信され、パーサーは同じページを読みます。アプリやログインが必要なものは対象外です。

どの WeChat URL に対応していますか?

mp.weixin.qq.com/s/<id> 形式の公開記事 URL — 公式アカウント投稿の標準シェアリンクです。

同じ記事が時々失敗するのはなぜですか?

Tencent がデータセンター出口 IP にアンチボットのキャプチャページを時折返します。その場合、チャレンジマークアップではなく ANTI_BOT 分類のエラーで失敗します — リトライで出口が切り替わり、通常は成功します。マトリクスにも正直に記載しています。

どんなメタデータが返りますか?

公式アカウント名、公開タイムスタンプ、記事内の全画像 URL のリスト — platform は "weixin" です。

記事の画像はインラインで返りますか?

いいえ — 画像は metadata.imageUrls にリンクとしてリストされます。Markdown 本文はテキストを、画像リストはアセットを保持します。

WeChat のスクレイピングは合法ですか?

当社が取得するのは WeChat が匿名訪問者に配信する記事ページのみです — ログイン、セッション共有、アクセス制御の回避は行いません。特定の用途が法や Tencent の規約に適合するかは管轄と用途次第なので、自社の法務にご確認ください。