知乎の記事・回答向けスクレイパー API
知乎のコラム記事または回答の直接リンクを Crawl に送信。専用パーサーが対象の本文を Markdown に変換し、取得できる場合は著者と公開日時も返します。
エンドポイント — bashPOST https://api.search1api.com/crawl{ "url": "https://zhuanlan.zhihu.com/p/2040015771137529694" }
コラム記事と個別回答を、読書・検索・アーカイブに使える形で取得。
公開コラム記事の見出し、リスト、リンク、画像を抽出。
回答の直接リンクから、収集したい回答本文を取得。
ページデータに含まれる著者情報と公開日時を本文に添付。
用途
中国語 RAG / 回答調査 / 記事アーカイブ
入力と出力
公開コラム記事と個別回答の、実際のページ 2 件です。左は匿名ブラウザーで撮影した元ページ、右は Crawl が返した Markdown 全文です。スクロールまたはコピーして最後まで確認できます。
zhuanlan.zhihu.com/p/2040015771137529694Zhihu が返すもの
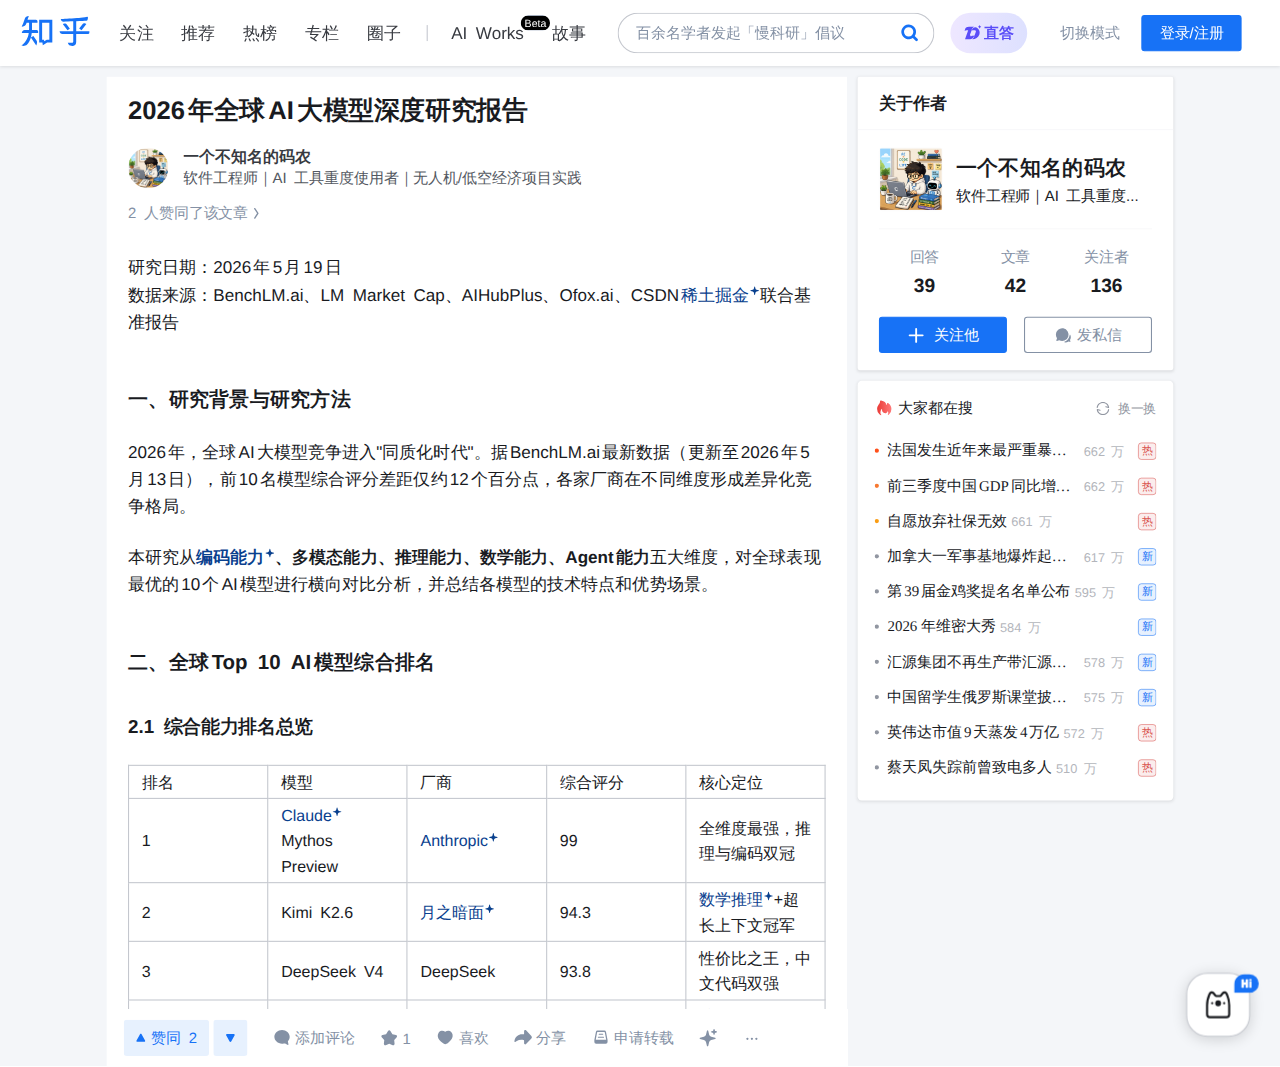
コラム記事 — タイトル、著者、本文と周辺 UI
API が返すもの
markdown研究日期:2026年5月19日数据来源:BenchLM.ai、LM Market Cap、AIHubPlus、Ofox.ai、CSDN稀土掘金联合基准报告## 一、研究背景与研究方法2026年,全球AI大模型竞争进入"同质化时代"。据BenchLM.ai最新数据(更新至2026年5月13日),前10名模型综合评分差距仅约12个百分点,各家厂商在不同维度形成差异化竞争格局。本研究从**编码能力、多模态能力、推理能力、数学能力、Agent能力**五大维度,对全球表现最优的10个AI模型进行横向对比分析,并总结各模型的技术特点和优势场景。## 二、全球Top 10 AI模型综合排名### 2.1 综合能力排名总览| 排名 | 模型 | 厂商 | 综合评分 | 核心定位 || -- | --------------------- | --------- | ---- | -------------- || 1 | Claude Mythos Preview | Anthropic | 99 | 全维度最强,推理与编码双冠 || 2 | Kimi K2.6 | 月之暗面 | 94.3 | 数学推理+超长上下文冠军 || 3 | DeepSeek V4 | DeepSeek | 93.8 | 性价比之王,中文代码双强 || 4 | GPT-5.5 | OpenAI | 91 | 编码+数学双项亚军 || 5 | GPT-5.4 Pro | OpenAI | 91 | 多模态+知识库全能选手 || 6 | Claude Opus 4.7 | Anthropic | 93.1 | 复杂架构设计+Agent最强 || 7 | Gemini 3.1 Pro | Google | 92 | 推理性价比最优,指令遵循满分 || 8 | Grok 4.1 | xAI | \~90 | Agent指令执行最快 || 9 | GPT-5.4 | OpenAI | 89 | 通用场景均衡旗舰 || 10 | DeepSeek V4 Pro | DeepSeek | 88 | 开源最强,可商用部署 |### 2.2 国产模型历史性突破**关键洞察**:2026年5月,国产模型首次包揽全球评测前两名。Kimi K2.6以94.3分登顶,DeepSeek V4以93.8分紧随其后,OpenAI GPT-5(93.5分)被挤至第三位。前六名综合分差仅约1.6分,竞争极度胶着。## 三、五大核心能力维度对比分析### 3.1 编码能力(权重20%)编码能力是2026年AI模型竞争最激烈的战场,SWE-bench Verified成为行业基准。### _编码能力Top 10_| 排名 | 模型 | SWE-bench评分 | 特点描述 || -- | ----------------------- | ----------- | ---------- || 1 | Claude Mythos Preview | 100 | 全维度编码最强 || 2 | GPT-5.5 | 98 | OpenAI编码旗舰 || 3 | GPT-5.4 Pro | 98 | 复杂代码处理强 || 4 | Gemini 3 Pro Deep Think | 95 | 深度推理辅助编码 || 5 | Claude Opus 4.7 | 94 | 多文件重构最强 || 6 | DeepSeek V4 Pro | 90 | 开源编码第一 || 7 | Claude Sonnet 4.6 | 81 | 性价比最优编码 || 8 | GPT-5.3 Codex | 80 | 终端操作领先12% || 9 | Kimi K2.6 | \~80 | 快速响应型编码 || 10 | Gemini 3.1 Pro | 80.6% | 大库分析成本最低 |### _编码能力深度分析_**三大编码王者的差异化定位**:| 维度 | Claude Opus 4.6 | GPT-5.3-Codex | Gemini 3.1 Pro || -------------- | --------------- | ------------- | -------------- || SWE-bench | 80.84%(最高) | 80.0% | 80.6% || Terminal-Bench | 65.4% | 77.3%(领先12%) | 68.5% || 价格(输出) | $25/M | $14/M | $12/M || 上下文窗口 | 200K(1M beta) | 400K | 1M(标准) || 核心优势 | 复杂多文件重构 | 终端密集型工作流 | 大型代码库分析 |**关键发现**:三者SWE-bench差距仅为0.84个百分点,标志着编程模型进入"同质化时代"。但在更难的SWE-Bench Pro(多文件任务)上,评分骤降至23-55%,这才是真实生产环境的考验。**国产编码能力**:DeepSeek V4的SWE-bench达到80.6%,Kimi K2.5达65.6%,均已进入第一梯队。### 3.2 多模态能力(权重12%)多模态能力从"视觉理解"升级为"文本+图像+音频+视频"四模态统一处理。### _多模态能力Top 5_| 排名 | 模型 | 多模态评分 | 支持模态 | 视觉分辨率 || -- | --------------------- | ----- | -------- | ------ || 1 | Claude Mythos Preview | 98 | 文本+图片 | 3.75MP || 2 | GPT-5.4 Pro | 98 | 文本+图片+音频 | 高清 || 3 | GPT-5.5 | 97 | 文本+图片+音频 | 高清 || 4 | Grok 4.1 | 97 | 文本+图片 | 高清 || 5 | Claude Opus 4.7 | 92 | 文本+图片 | 3.75MP |### _多模态深度分析_**Gemini 3.1 Pro的差异化优势**:**·** **唯一四模态原生支持**:文本+图像+音频+视频统一处理**·** **1M token标准上下文**:无beta限制,支持完整视频分析**·** **成本优势**:输入$2/M,输出$12/M,性价比最高**Claude Opus 4.6的多模态突破**:· 视觉分辨率提升至2576px(约3.75MP)· 与编码能力形成"视觉+代码"双重优势· 特别适合UI截图→代码转换、错误图分析### 3.3 推理能力(权重17%)推理能力成为拉开差距的关键维度,ARC-AGI-2成为新标杆。### _推理能力Top 5_| 排名 | 模型 | 推理评分 | 核心指标 | 特点 || -- | --------------------- | ---- | ---------------- | ---------------------- || 1 | Claude Mythos Preview | 100 | \- | 全维度最强 || 2 | Claude Opus 4.7 | 95 | ARC-AGI-2: 68.8% | Adaptive Thinking自适应推理 || 3 | Gemini 3.1 Pro | 94 | ARC-AGI-2: 77.1% | 推理能力翻倍以上 || 4 | DeepSeek V4 Pro | 91 | \- | 极致性价比推理 || 5 | GPT-5.4 | 89 | \- | 复杂推理最强 |### _推理能力深度分析_**Gemini 3.1 Pro的推理突破**:· GPQA Diamond达到94.3%(科学推理)· ARC-AGI-2达77.1%,领先Claude Opus 4.6约8个百分点· Deep Think推理模式默认集成,无需手动切换**Claude Opus 4.7的Adaptive Thinking**:· 四级思考深度控制(low/medium/high/max)· 自动判断推理深度,平衡速度与准确性· 适合复杂架构规划和长时运行的多智能体协作### 3.4 数学能力(权重5%)数学能力是2026年模型竞争的新焦点,FrontierMath成为最难题库。### _数学能力Top 5_| 排名 | 模型 | 数学评分 | AIME 2025 | MATH-500 || -- | --------------------- | ---- | --------- | -------- || 1 | Claude Mythos Preview | 100 | \- | \- || 2 | GPT-5.5 | 97 | \- | \- || 3 | GPT-5.4 | 96 | \- | \- || 4 | Claude Opus 4.6 | 95 | \- | \- || 5 | Grok 4.1 | 91 | \- | \- |### _国产数学能力突破_**关键发现**:Kimi K2.6在MATH-500拿到97.8分,超越GPT-5.4的96分,成为数学推理单项冠军。### 3.5 Agent能力(权重22%)Agent能力是2026年权重最高的评测维度,反映模型在复杂任务中的自主执行能力。### _Agent能力Top 5_| 排名 | 模型 | Agent评分 | 核心能力 || -- | --------------------- | ------- | ----------------- || 1 | Claude Mythos Preview | 100 | 全维度Agent最强 || 2 | GPT-5.3-Codex | 100 | 指令遵循满分 || 3 | Grok 4.1 | 99 | Agent指令执行最快 || 4 | Gemini 3.1 Pro | 100 | 指令遵循满分 || 5 | Claude Opus 4.7 | \~75 | Agent Teams多智能体协作 |### _Agent能力深度分析_**Claude Opus 4.7的Agent Teams**:· 多个Claude实例并行运行工具和子智能体· 支持Compaction API压缩长对话· Computer Use可操作软件、浏览网页· 最适合:复杂多步骤任务、自动化工作流**国产Agent突破**:· GLM-5.1:可独立工作长达8小时· MiniMax-M2.7:支持模型自我迭代· Kimi Claw:支持OpenClaw一键部署## 四、各模型技术特点与优势场景### 4.1 Claude Mythos Preview(Anthropic)| 项目 | 详情 || ----- | -------------------------------------- || 综合评分 | 99/100 || 厂商定位 | 全维度最强,推理与编码双冠 || 核心技术 | Agent Teams、Adaptive Thinking、四级思考深度控制 || 最大上下文 | 1M tokens || 定价 | 输入$25/M,输出$125/M |**技术优势**:· 8个评测维度中6项第一· 编码、推理、数学均为满分· Agent Teams支持真正的多智能体协作**最佳场景**:· 复杂软件架构设计· 大规模代码重构· 高价值Agent工作流· 多步骤自动化任务### 4.2 Kimi K2.6(月之暗面)| 项目 | 详情 || ---- | --------------------------- || 综合评分 | 94.3/100(第1名) || 厂商定位 | 数学推理+超长上下文冠军 || 核心技术 | 200万Token上下文、MATH-500得分97.8 || 开源状态 | 可部署 || 定价 | 输入$1/M,输出$4/M |**技术优势**:· 国产首次登顶全球第一· MATH-500得分97.8,数学单项最强· 200万Token超长上下文支持· Kimi Claw支持OpenClaw一键部署**最佳场景**:· 超长文档分析(百万字级)· 数学推理与证明· 复杂长篇小说分析· 追求国产化的企业### 4.3 DeepSeek V4(DeepSeek)| 项目 | 详情 || ---- | ------------------- || 综合评分 | 93.8/100(第2名) || 厂商定位 | 性价比之王,中文代码双强 || 核心技术 | 华为昇腾芯片训练、中文理解最强 || 开源状态 | 完全开源可商用 || 定价 | 输入$0.28/M,输出$1.12/M |**技术优势**:· 推理成本仅竞品1/20\~1/90· 中文理解能力超越GPT-5.4· SWE-bench 80.6%,进入第一梯队· 90%上下文缓存折扣**最佳场景**:· 中文内容处理(写作、对话)· 成本敏感的规模化应用· 需要开源可商用的企业· 高并发API调用### 4.4 GPT-5.5(OpenAI)| 项目 | 详情 || ----- | ---------------- || 综合评分 | 91/100 || 厂商定位 | 编码+数学双项亚军 || 核心技术 | 多模态统一架构、Agent工作流 || 最大上下文 | 1M tokens || 定价 | 输入$5/M,输出$30/M |**技术优势**:· 编码98分,仅次于Claude Mythos· 数学97分,处于第一梯队· 多语言能力98分· Agent工作流为核心优势**最佳场景**:· 复杂软件工程任务· 多语言国际化产品· Agent工作流搭建· 追求GPT生态的企业### 4.5 GPT-5.4 Pro(OpenAI)| 项目 | 详情 || ----- | ---------------- || 综合评分 | 91/100 || 厂商定位 | 多模态+知识库全能选手 || 核心技术 | 视觉高清理解、庞大知识库 || 多模态评分 | 98/100 || 定价 | 输入$2.5/M,输出$15/M |**技术优势**:· 多模态98分,与Claude并列第一· 知识库100分,覆盖最广· 多语言能力60分(相对短板)· 价格适中,性能均衡**最佳场景**:· 多模态内容理解(图文混合)· 企业知识库问答· 视觉+文本混合任务· 需要广泛知识的场景### 4.6 Claude Opus 4.7(Anthropic)| 项目 | 详情 || ----- | --------------------------------- || 综合评分 | 93.1/100 || 厂商定位 | 复杂架构设计+Agent最强 || 核心技术 | Agent Teams、Computer Use、128K最大输出 || 视觉分辨率 | 3.75MP(行业最高) || 定价 | 输入$5/M,输出$25/M |**技术优势**:· SWE-bench Verified最高分(80.84%)· 四级思考深度控制· Computer Use可操作系统界面· Agent Teams支持多智能体协作**最佳场景**:· 复杂代码架构设计· 大规模代码审查· UI截图→代码转换· 多步骤复杂Agent任务### 4.7 Gemini 3.1 Pro(Google)| 项目 | 详情 || ---- | -------------------------- || 综合评分 | 92/100 || 厂商定位 | 推理性价比最优,指令遵循满分 || 核心技术 | 四模态原生(文本+图像+音频+视频)、2M上下文 || 推理指标 | GPQA 94.3%、ARC-AGI-2 77.1% || 定价 | 输入$2/M,输出$12/M(最低) |**技术优势**:· 唯一四模态原生支持· 指令遵循100分满分· 推理能力比上代翻倍以上· 价格最低,性价比最高**最佳场景**:· 视频内容分析· 成本敏感型企业· 长文档深度理解· 需要指令精确执行的任务### 4.8 Grok 4.1(xAI)| 项目 | 详情 || ------- | ----------- || 综合评分 | \~90/100 || 厂商定位 | Agent指令执行最快 || 核心技术 | 实时信息接入、高速推理 || Agent评分 | 99/100 || 定价 | 中等价位 |**技术优势**:· Agent指令遵循99分· 实时信息接入能力强· 推理速度优化· 与X平台深度整合**最佳场景**:· 实时信息查询与整合· 高速Agent任务· X平台生态用户· 需要最新信息的场景### 4.9 GPT-5.4(OpenAI)| 项目 | 详情 || ----- | ---------------- || 综合评分 | 89/100 || 厂商定位 | 通用场景均衡旗舰 || 核心技术 | 复杂推理与编码均衡 || 最大上下文 | 270K tokens || 定价 | 输入$2.5/M,输出$10/M |**技术优势**:· 综合能力均衡· 指令跟随能力强· 多语言99分· 复杂推理能力强**最佳场景**:· 日常通用任务· 需要均衡能力的场景· 格式控制要求高的任务· 中等长度文档处理### 4.10 DeepSeek V4 Pro(DeepSeek)| 项目 | 详情 || ---- | ------------------- || 综合评分 | 88/100 || 厂商定位 | 开源最强,可商用部署 || 核心技术 | 开源可商用、中文优化 || 开源状态 | 完全开源 || 定价 | 输入$1.74/M,输出$3.48/M |**技术优势**:· 开源模型综合第一· 可完全私有化部署· 中文能力强· 性价比极高**最佳场景**:· 需要开源合规的企业· 私有化部署需求· 中文为主的应用· 成本敏感的开源项目## 五、场景化选型指南### 5.1 按任务类型选型| 任务类型 | 推荐模型 | 备选方案 | 选型理由 || -------- | --------------- | --------------- | ------------------ || 复杂代码重构 | Claude Opus 4.7 | GPT-5.3-Codex | SWE-bench最高,多文件处理强 || 快速原型开发 | GPT-5.3-Codex | Kimi K2.6 | 终端操作领先,速度快 || 大型代码库分析 | Gemini 3.1 Pro | Claude Opus 4.7 | 1M上下文无beta限制 || 数学推理证明 | Kimi K2.6 | GPT-5.5 | MATH-500得分97.8 || 视频内容分析 | Gemini 3.1 Pro | GPT-5.4 Pro | 四模态原生支持 || UI截图→代码 | Claude Opus 4.7 | GPT-5.4 Pro | 3.75MP视觉分辨率 || 超长文档分析 | Kimi K2.6 | Gemini 3.1 Pro | 200万Token上下文 || Agent工作流 | Claude Opus 4.7 | GPT-5.5 | Agent Teams多智能体 || 中文内容处理 | DeepSeek V4 | Kimi K2.6 | 中文理解最强 || 成本敏感项目 | Gemini 3.1 Pro | DeepSeek V4 | 价格最低,性能相当 |### 5.2 按预算选型┌─────────────────────────────────────────────────────────────────┐│ 预算导向选型策略 │├─────────────────────────────────────────────────────────────────┤│ 高预算(>100万/月tokens) ││ 首选:Claude Mythos Preview(最强综合能力) ││ 备选:Claude Opus 4.7(复杂架构任务) │├─────────────────────────────────────────────────────────────────┤│ 中预算(10-100万/月tokens) ││ 首选:Gemini 3.1 Pro(性价比最优) ││ 备选:GPT-5.4(均衡通用) │├─────────────────────────────────────────────────────────────────┤│ 低预算(<10万/月tokens) ││ 首选:DeepSeek V4(极致性价比) ││ 备选:Kimi K2.6(国产首选) │├─────────────────────────────────────────────────────────────────┤│ 开源/私有化部署 ││ 首选:DeepSeek V4 Pro(开源最强) ││ 备选:Qwen3-235B(阿里系) │└─────────────────────────────────────────────────────────────────┘### 5.3 智能路由策略**最佳实践**:采用模型路由策略可节省40-60%成本。日常任务层:Gemini Flash Lite / DeepSeek Flash($0.10-0.50/M)↓ 路由条件:简单问答、文本分类、高频批量标准任务层:Gemini 3.1 Pro($12/M输出)↓ 路由条件:大多数开发任务、内容生成、数据分析复杂任务层:Claude Opus 4.7 / GPT-5.3-Codex($14-25/M输出)↓ 路由条件:复杂架构、多文件重构、深度推理旗舰任务层:Claude Mythos Preview($125/M输出)路由条件:最高价值任务、关键决策、极限性能要求## 六、关键发现与趋势洞察### 6.1 2026年五大关键发现**1.** **国产崛起**:Kimi K2.6(94.3分)和DeepSeek V4(93.8分)首次包揽全球前两名,标志着国产模型正式进入第一梯队。**2.** **同质化竞争**:前10名模型综合评分差距约12个百分点,SWE-bench差距仅0.84个百分点,选型逻辑从"追求最强"转向"场景化匹配"。**3.** **价格革命**:DeepSeek V4将推理成本降至竞品1/20\~1/90,百万Token上下文不再是"富人专属",10人团队月预算可从2000元降至800元。**4.** **开源优先**:Kimi K2.6、DeepSeek V4、Qwen3-235B等开源模型追平甚至超越闭源旗舰,"开源优先"成为开发者理性选择。**5.** **Agent为王**:Agent能力权重升至22%成为最高权重维度,Claude Opus 4.7的Agent Teams、Computer Use能力成为差异化关键。### 6.2 技术演进趋势| 趋势 | 当前状态 | 演进方向 || ------- | ------------------- | ----------------------------- || 上下文窗口 | 1M-2M tokens | 10M tokens(如Nemotron 3 Ultra) || 多模态融合 | 四模态统一处理 | 原生多模态成为标配 || 推理范式 | Deep Think/Adaptive | 自动推理深度判断 || Agent能力 | 单Agent协作 | 多Agent Teams并行 || 开源生态 | 快速追赶 | 部分维度超越闭源 |## 七、附录:完整Benchmark数据### 7.1 综合评分详细对比| 排名 | 模型 | 综合 | 编码 | 推理 | 多模态 | 知识 | 多语言 | 数学 | 指令遵循 || -- | --------------- | ---- | ---- | --- | --- | --- | --- | ---- | ---- || 1 | Claude Mythos | 99 | 100 | 100 | 98 | 99 | 100 | \- | 91 || 2 | Kimi K2.6 | 94.3 | \~80 | 89 | \- | 68 | 76 | 97.8 | \- || 3 | DeepSeek V4 | 93.8 | 90 | 91 | \- | \- | 78 | \- | \- || 4 | GPT-5.5 | 91 | 98 | 84 | 97 | 57 | 98 | 97 | \- || 5 | GPT-5.4 Pro | 91 | 92 | 92 | 98 | 100 | 60 | 94 | 93 || 6 | Claude Opus 4.7 | 93.1 | 94 | 95 | 92 | 48 | 99 | \- | 75 || 7 | Gemini 3.1 Pro | 92 | 87 | 94 | 96 | 82 | 95 | 68 | 100 || 8 | Grok 4.1 | \~90 | 79 | 83 | 97 | 98 | 95 | 91 | 99 || 9 | GPT-5.4 | 89 | 88 | 89 | 96 | 58 | 99 | 96 | 94 || 10 | DeepSeek V4 Pro | 88 | 90 | 91 | \- | \- | 78 | \- | \- |### 7.2 价格对比总览| 模型 | 输入价格 | 输出价格 | 上下文窗口 | 性价比评级 || --------------- | ------- | ------- | --------- | -------- || Claude Mythos | $25/M | $125/M | 1M | ⭐⭐ || Claude Opus 4.7 | $5/M | $25/M | 1M | ⭐⭐⭐ || GPT-5.5 | $5/M | $30/M | 1M | ⭐⭐ || GPT-5.4 Pro | $2.5/M | $15/M | 1M | ⭐⭐⭐ || GPT-5.4 | $2.5/M | $10/M | 270K | ⭐⭐⭐ || Gemini 3.1 Pro | $2/M | $12/M | 1M(标准) | ⭐⭐⭐⭐⭐ || Grok 4.1 | 中等 | 中等 | 较长 | ⭐⭐⭐ || Kimi K2.6 | $1/M | $4/M | 200万Token | ⭐⭐⭐⭐ || DeepSeek V4 | $0.28/M | $1.12/M | 128K | ⭐⭐⭐⭐⭐ || DeepSeek V4 Pro | $1.74/M | $3.48/M | 128K | ⭐⭐⭐⭐(开源) |## 八、数据来源与参考文献**1.** **BenchLM.ai** \- LLM Leaderboard 2026(更新至2026年5月13日)**2.** **LM Market Cap** \- Best AI Models in 2026 Complete Ranking**3.** **AIHubPlus** \- 大模型排行榜:2026年主流大语言模型综合能力排名**4.** **Ofox.ai** \- 2026大模型排行榜:10+主流AI模型实测排名与选型指南**5.** **CSDN & 稀土掘金** \- 2026年5月AI大模型实测联合基准报告**6.** **Particula.tech** \- Claude Opus 4.6 vs GPT-5.3 Codex vs Gemini 3.1编程能力深度对比
Markdown 全文 — 14,934 文字 · スクロール・全文コピーに対応
www.zhihu.com/question/574984177/answer/2818374142Zhihu が返すもの
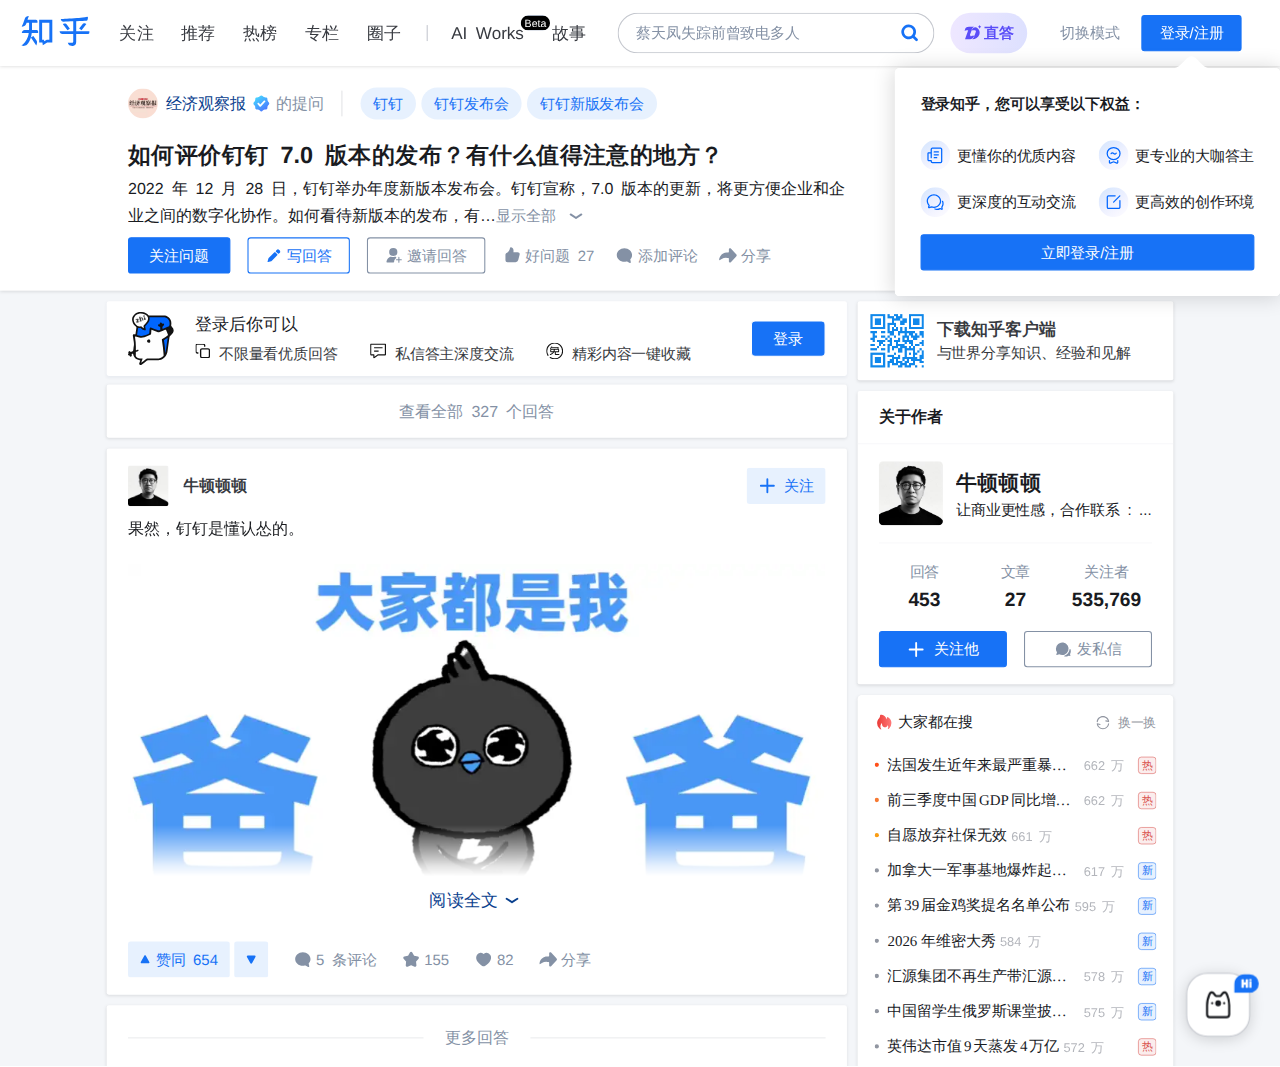
回答ページ — 質問タイトル、著者と回答の最初の画面
API が返すもの
markdown果然,钉钉是懂认怂的。发布会还是挺有意思的:2C这碗饭不好吃,那就加大力度往2B干。作为钉钉的老用户,要说这次大版本更新有什么值得注意的地方?首先就是“带头认怂”。**1****从产品的角度来讲,钉钉在做一些很新的设计。**或许效率协同工具也能够做出边界感,通过功能逐步去引导一种更良性的职场文化。作为**效率协同类软件的老大哥,之前大家诟病非常多的地方就是:****过强的侵入性。**作为一个关注钉钉两年半的科技练习生,之前我就回答过类似的问题:哪一瞬间你发现钉钉原来还能这样用?<https://www.zhihu.com/question/371193047/answer/1014706463>那段时间,无数老师被迫上线营业,变成了十八线上课主播。MC牛老师在线答疑:“兄弟们,听懂的扣波666”多少是带点魔幻的。顺着这波潮流,钉钉也是一骑绝尘,一度变成了App store的榜一大哥。但在广大中小学生组成的“分期”五星好评的钢铁洪流中,也是被打得鼻青脸肿:对于无数打工人来说,那一声声宛如判官催命的消息提醒,更是让人头皮发麻。下班之后恨不得把手机和电脑丢到M78星云。所以这次,钉钉学聪明了。不就是怕打扰吗?继续改。就拿这次新推出的“定时发送消息”来说。如果你不想在下班之后打扰同事,或者同事怕打扰你,都可以设置消息定时发送。而且也可以发静音消息。当你下班既想回复同事消息,又怕打扰对方的时候,就可以使用这个功能。同事收到消息只会有红点,不会有要人命的铃声和通知。果然,集美们,差评真的有用。在钉钉会议方面,这次也升级为了2.0版本。比如里面的字幕功能,支持会议语音实时转文字和中英互译。对于我这种熟读“abandon”的英语神童来说,可以说是相当实用了。当然,钉钉毕竟只是工具,最终“免打扰”的效果有多大,还得看你的老板当不当人了。**2**说完钉钉的“人性化”,我们再来聊聊这次升级最大的亮点“开放性”。之前有个新闻,讲的是杭州亚运会选择使用钉钉,**让志愿者和工作人员在“亚运钉”平台上进行协作。**赛事组织和一般的企业协作逻辑上还是有很大的差异的。毕竟,这是涉及十数万工作人员和志愿者的线上协同,而且还得跨地区、跨部门、跨层级沟通,角色负责,而且工作人员之间的语言还可能不一样。我说ABC,他说开飞机,你唱着阳光彩虹小白马,他说你不懂棉花和西瓜,顺带哐哐给你两拳......这些场景协作堪称地狱难度。亚运钉就充分体现出了这种“开放性”。不过就是人多了点,人员构成杂了点吗?解决,都能解决。比如在沟通方面,亚运钉分门别类搭建了通讯录。工作人员可以通过检索快速定位,不用加好友就可以直接在线solo。并且考虑到语言不通的问题,亚运钉还添加了智能翻译功能,支持汉语、英语、日语等13种语言的实时翻译。算上吉祥物,说不定跨物种也给你解决了。当然,这还不够。面对这场大型国际赛事,亚运钉不仅提供了文档在线快速预览审阅、多方同时修订等功能,还制定了应用统一管理的标准,像是行政审批、会议、培训服务等等都给你在线解决了。细,还是钉钉细。从企业到组织之间的协作逻辑,体现出钉钉的产品设计背后另一个逻辑:开放性。这几年无论是产品还是企业,都是越来越封闭,互联网都有点“互不联网”的阵势了。外卖、快递、音乐、出行等领域的巨头各自占山为王,看个视频都能细分出快抖b、爱优腾等APP,不光是用户觉得“封闭”不方便,企业的员工也觉得这种封闭是反效率的。尤其是不同公司之间的协作,恨不得跟特务执行任务一样,各自的OA系统和IM完全封闭,非常折磨人。而钉钉在饱受广大中小学生和打工人的凌辱之后,也觉醒了一点奇怪的属性,变得更open了。组织内折腾也就图一乐,真开放还得扩大“朋友圈”,往不同组织间折腾。特别是钉钉这次新版本的“群2.0”,对于2B的产品来说,是一种很新的开放性产品理念。当然,这个群2.0是相对曾经广受用户“好评”的群1.0来说的:基本上,只要你多呆几家公司,都少不了要和1打交道。什么打卡、记录考勤、项目管理、会议沟通等等逃不过它的身影。对很多公司来说,它是一种高效的管理协作方式,只不过,对打工人来说,体验可能就不是那么友好了。我还记得当年钉钉推出了一个非常sexy的功能——笑脸打卡。得分高的还能荣登笑脸墙,供全司瞻仰:怎么说呢,在那个阳光灿烂的清晨,要不是我那酷似吴彦祖的容颜,多少是有点顶不住的。当然,这些功能基本仅限公司内部。**而群2.0简单理解,就是加载了新模块,玩的是“跨组织协同”。**没和其他公司打过交道的可能没法理解,这个功能的意义。这么说吧,闯荡江湖多年,我也和很多公司进行过协作。如果项目时间充足,公司之间的配合度高,那基本问题不大。但一旦遇到那种不紧不慢的,那就要老命了。拉群、沟通需求、外部沟通完还得等他们内部沟通,开个会还得到处喊人,参会人数一多,可能也分不清楚谁是谁了。更别说群里文件过期、反复传输等等问题。鲁迅看了都得喊一声“厚障壁”。群2.0这个船新版本,相当于给不同公司之间的协作多搭了一条高速公路。举个例子,新版本之后,开视频会议只需要会议号或者链接就可以入会。并且在不同公司之间开会的时候,还会显示成员的企业名片,方便大家各找各甲方爸爸。不用担心两眼一抹黑。而且和以往不一样的是,像文档、知识库也能够在群里传给其他公司的人员。直接就是“性感员工,在线多人编辑”。不用反复修改、传输、修改、传输......就连Teambition也加载了“跨组织”的新能力。大家在群里就能实时了解项目进展。可以说,钉钉的群2.0把不同企业之间协作的门槛给大幅降低了。**除此之外,整个钉钉7.0版本看下来,其实还有一个很明显的感受,钉钉在2B方面的服务是越来越“丧心病狂”了。**最明显的,当属钉钉如今超过1500款的SaaS应用。诸如智能租赁、智能招聘、智能合同等等都可以按需购买。你就说,你想要啥服务吧?为了吸引更多的企业进驻,它还支持企业在钉钉上开辟2B服务的新场景。比如携程这个原本主要2C的的企业,现在在2B方面也混得风生水起。这种开放程度和包容性,把办公协同的维度拉了一个层次。前段时间,QuestMobile发布了一份数据:从2014底发布至今,钉钉的月活已经超过了2.5亿。经历了上学和假期间流量的大起大落,钉钉也加大了2B的拓展,如今它在办公领域的量级和优势,是其他软件很难比拟的。我们很难期望一个办公软件能完全解决工作中的所有问题。但也希望像钉钉这样的国民级办公软件,除了降低企业内部和企业间沟通、协作的门槛,也能够带头去塑造和引导一种更开放,更健康,更文明的职场关系。至少,让广大打工人,少掉一点头发。
Markdown 全文 — 2,922 文字 · スクロール・全文コピーに対応
別の Zhihu リンクでも確認できます
取得できるページ
どちらの URL も同じ /crawl エンドポイントで利用できます。リンクで指定した記事・回答の本文が返ります。
| URL パターン | ステータス | 取得できる内容 |
|---|---|---|
zhuanlan.zhihu.com/p/<article-id> | 対応 | コラム記事の本文を Markdown に変換。見出し、リンク、コード、画像を保持。 |
(www.|m.)zhihu.com/question/<question-id>/answer/<answer-id> | 対応 | 指定した回答を Markdown で取得。質問タイトルと、取得できる著者・公開日時を添付。 |
対象の本文を読む
知乎の画面では回答が折り畳まれ、記事の周囲にログイン案内やおすすめが表示されます。パーサーはページデータから対象 ID の本文を読み、抜粋や別の回答による代用を防ぎます。
長文記事を取得
コラム記事を索引化・保存できる Markdown で取得。
回答を指定して収集
直接リンクで、調査やナレッジベースに使う回答を選択。
書式を保持
見出し、リスト、コード、出典リンク、画像 URL の構造を保持。
出典を一緒に保存
タイトルと、取得できる著者・公開日時を本文と一緒に管理。
知乎スクレイパー API とは?
知乎スクレイパー API は、公開コラム記事や個別回答をアプリケーションで読める形に変換します。Search1API は本文の書式と取得できる出典情報を保持し、検索・読書・アーカイブ向けの Markdown を返します。
典型的な流れ
知乎のコラム記事または回答の直接リンクを Crawl に送信。専用パーサーが対象の本文を Markdown に変換し、取得できる場合は著者と公開日時も返します。
コラム記事 URL または回答の直接リンクを /crawl に POST。
レスポンスからタイトルと Markdown 本文を読む。
元 URL と一緒に、取得できた author・publishedTime を保存。
本文を索引化、アーカイブ、またはアプリケーションへ渡す。
利用例
中国語の公開記事を検索用に索引化。
元リンク付きで個別回答を収集。
読みやすい Markdown の記事アーカイブを作成。
直接リンクを持つ複数の回答を比較。
FAQ
知乎から何を取得できますか?
公開コラム記事と個別回答です。上記に両方のページ種別で成功した Crawl レスポンスを掲載しています。
書式は保持されますか?
はい。見出し、リスト、コード、通常のリンク、画像を Markdown に変換。知乎の検索リンク装飾は除去し、テキストを保持します。
著者と公開日時も取得できますか?
元データに含まれる場合は author と publishedTime を title・content と一緒に返します。
自分のリンクを試すには?
URL-to-Markdown ツールを開くか、上記のリクエスト例に従い記事・回答の URL を /crawl に POST してください。
対応範囲は?
コラム記事と回答の直接リンクに対応。質問一覧、プロフィール、トピック、コメントは対象外です。サイトのアクセス確認により失敗する場合があります。